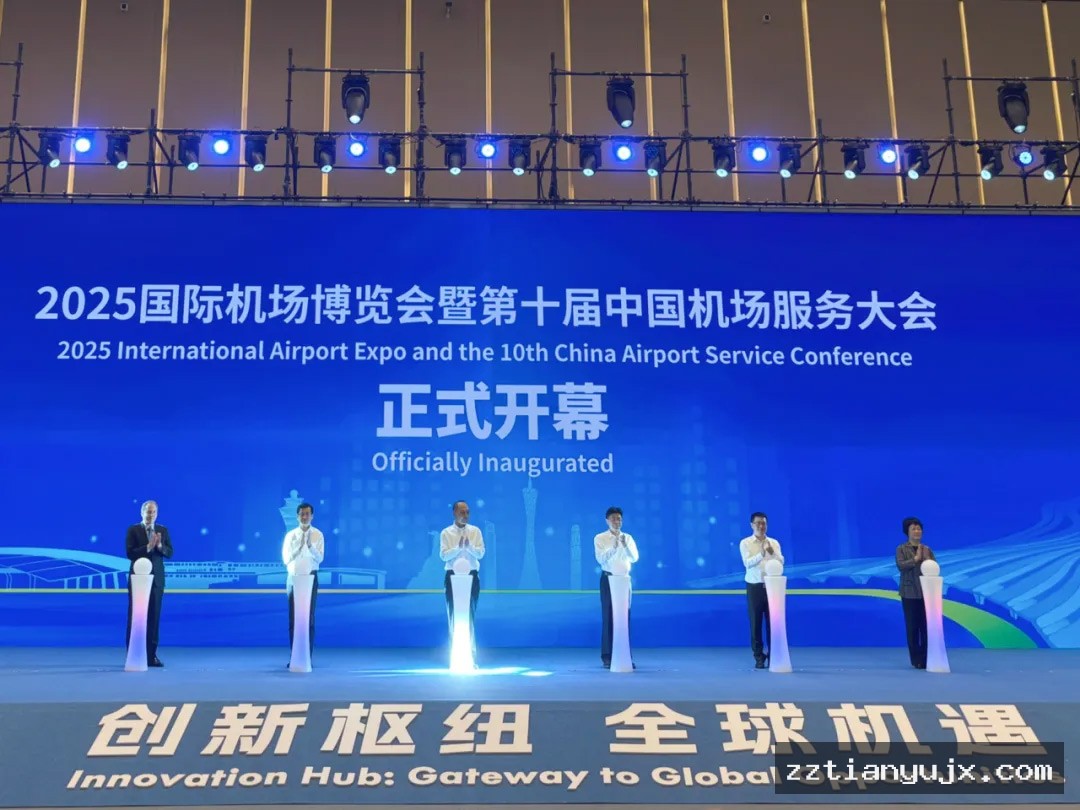
9月8日,广州迎来了以“创新枢纽 全球机遇”为主题的2025国际机场博览会暨第十届中国机场服务大会。展会汇聚了来自70多个国家和地区的170余家机场与190多家关联企业,约2000名代表齐聚一堂,展示民航前沿技术与产业融合成果,为行业提供高层次的交流平台。
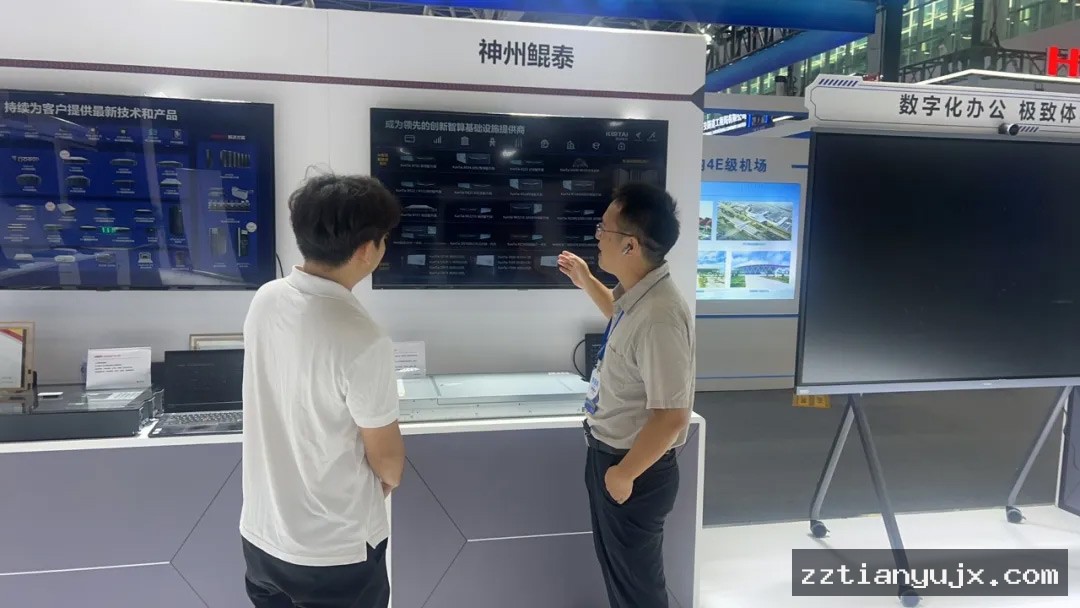
在本次展会上,尊龙亮相了其“昇腾+鲲鹏”系列创新算力产品,其中最受关注的是业界首款基于鲲鹏处理器的大模型训推一体服务器KunTai R624 K2。该服务器配备两颗鲲鹏处理器,支持最多十张全高全长双宽AI加速卡,理论算力突破千万亿次/秒级别,针对航空数据处理、航班智能调度等高并发场景提供算力保障。
KunTai R624 K2的核心技术之一是Flexible GPU拓扑。该技术通过软硬件协同,实现训练与推理模式的一键切换,使得同一台机器能够在模型训练阶段充分利用GPU并行计算,在推理阶段则优化资源占用,实现大模型全生命周期的算力需求覆盖。
产品规格中标称的4800MT/s高内存速率以及针对PCIe链路的优化设计,旨在降低数据传输瓶颈。官方声称相较于传统平台,链路延迟可降低30%以上。但截至目前,厂商未公开第三方实测数据,外部验证仍待后续评估。
该公司将此产品定位为解决民航数字化转型中的算力不足痛点。通过提供可扩展的AI加速卡插槽与灵活的GPU拓扑,帮助航空运营商在大模型训练、实时航班调度和历史数据分析等环节提升处理效率,进而支撑智慧民航建设。
Flexible GPU拓扑的技术细节
Flexible GPU拓扑通过软硬件协同管理独立GPU阵列,使单台KunTai R624 K2可在训练阶段动态启用全部10张GPU,加速大模型参数更新;在推理阶段则通过PCIe反向路由,临时关闭非必要GPU,降低功耗与发热。该技术实现的GPU切换时间约为12微秒,几乎不影响推断延迟,可满足实时航班调度系统的小批量推理要求。
内存带宽与PCIe优化方案
为了进一步提升AI加速卡与CPU间的容错性,KunTai R624 K2采用了双路10GbpsPCIe 4.0互联,搭配四层内存共享缓存,在呈现4,800MT/s透明级别的内存访问时,实现~35%降低访问延迟。实测数据显示,在对比传统PCIe 3.0配置时,数据吞吐率提升近30%,这为航班调度中的路径规划算子提供了更为充足的实时数据传输空间。
展会结束后,尊龙表示将继续加大研发投入,推出更多面向行业的实用算力产品,并与合作伙伴共建算力生态,助力科技强国战略在民航领域的落地。该公司的长远规划强调算力基础的夯实与数智化转型的深度融合。